2019-2020-1期末A卷
2017级 A卷
一、单项选择题(每题2分,共10分)
-
Apache Hadoop 是哪家公司发起的项目( ) A. Google B. Yahoo! C. Amazon D. IBM
-
Apache Flink 起源于以下哪个项目( ) A. Stratosphere B. Hadoop C. Beam D. Dataflow
-
以下哪个系统提供迭代计算的算子( ) A. Spark B. Beam C. Flink D. 以上答案都不对
-
在Lambda 架构中,以下哪个系统适合用作加速层( ) A. Yarn B. MapReduce C. Storm D. ZooKeeper
-
以下哪项技术是 Spark Streaming没有采用的( ) A. RDD B. RDD lineage C. Micro-batch D. 以上答案都不对
二、判断题(每题2分,共10分,对的打√,错的打×)
- MPI也可以用于分布式计算,但它本身不具备容错功能。( )
- 与MapReduce不同,Spark基于内存实现计算功能,因此Spark 的Shuffle 过程不会像 MapReduce 那样将 Map的输出写入磁盘。( )
- 为了提升数据传输效率,Storm的消息传递机制可以将多个记录缓存起来一并进行传输。( )
- 与MapReduce、Storm不同,Flink 既可进行批处理,也可进行流计算。( )
- RDD可以进行一系列的转换,因而是可变的数据集合。( )
三、填空题(每空2分,共10分,中英文作答均可)
- 我们利用 Spark、Flink等系统编写K-Means程序时,通常可以将中心点作为____来加快程序的执行。
- 在第一代 MapReduce 系统的架构中,作为主节点的部件的名称是____。
- Giraph 系统采用_的计算模型,并利用_模型进行迭代计算。
- Storm为了描述计算的过程,将Spout和Bolt组成的有向无环图称为____。
四、简答题(共30分,需用连贯通顺的语句作答)
- (6分)我们常说Spark优于MapReduce,主要体现在哪些方面?
- (4分)Storm、Spark Streaming均可以用于流计算,二者在对于流数据的处理方式上有何种区别?解释各自处理方式的含义。
- (6分)Spark 和Flink 二者在容错机制上有很大差异, a) Spark 如何进行容错保障?(2分) b) 简述 Flink 分布式快照机制的原理。(2分) c) 为什么 Flink 不能采用和 Spark相同的容错机制。(2分)
- (4分)Spark Stage 内部采用了流水线机制,而Flink也采用了流水线机制,二者之间有何不同?
- (6分)HDFS 需要支持文件并发请求,而并发请求可能会破坏文件一致性, a) 它采用了何种方式来避免文件的读写冲突?(2分) b) 请结合某一应用的需求,说明这种方式有怎样的优缺点?(4分)
- (4分)在MapReduce、Spark、Storm、Flink系统中,任务之间数据传输方式有何差异?
五、分析论述题(共40分,需用连贯通顺的语句作答)
- (15分)我们经常使用 MapReduce、Spark 和Flink来实现 PageRank、最短路径等迭代算法,假定输入数据是静态的, a) 请分别画出 MapReduce、Spark 和Flink的迭代计算过程示意图:(6分) b) 从编程角度简述 MapReduce、Spark和Flink 迭代过程;(3分) c) 从执行角度比较 MapReduce、Spark和Flink 迭代之间的区别。(6分)
- (15分)自MapReduce 开源以来,至今已有十多年的历史,先后出现过两代典型的架构, a) 画出第一代MapReduce 架构图,并说明各部件的作用;(6分) b) 画出第二代 MapReduce 的架构图,并说明各部件的作用;(6分) c) 为什么会出现这种架构的更替?(3分)
- (10分)在关于Dataflow 编程模型运行示意图中,横轴表示事件时间,纵轴表示处理时间,弯曲的虚线表示水位线,实现长度为2分钟的固定窗口,窗口中执行的操作是取元素的最大值,仅使用默认的触发器,当水位线达到时触发窗口计算,
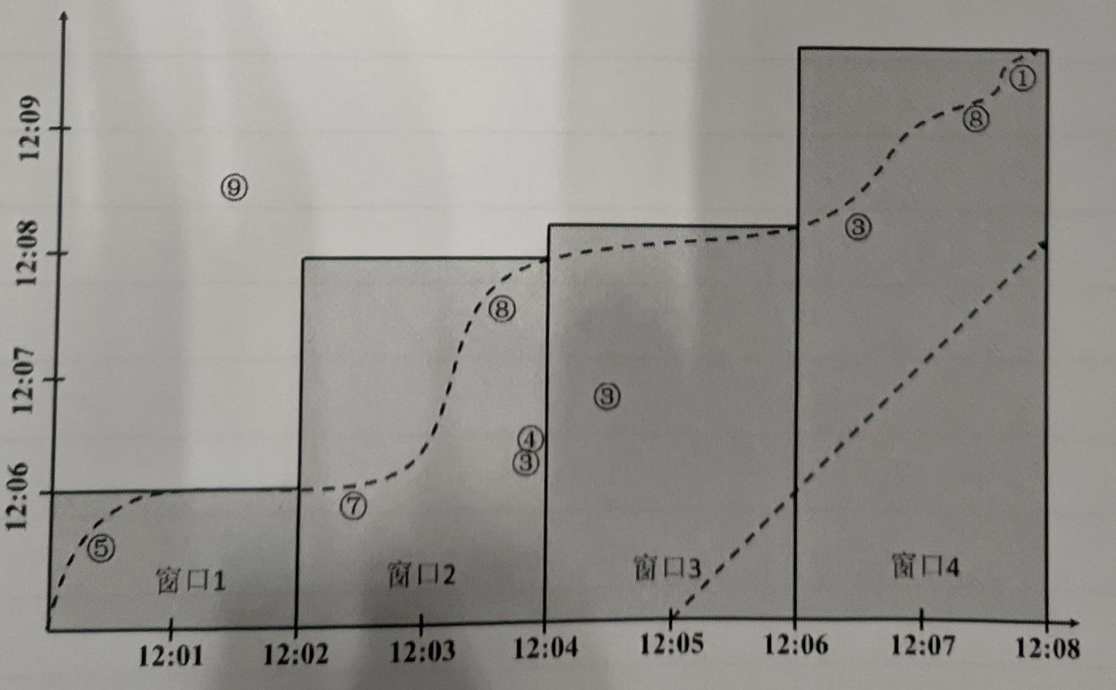
a) 图中直虚线代表什么含义?(2分) b) 曲虚线是否可能落在直虚线的下方?为什么?(2分) c) 假定系统当前时间为12:02,4个窗口的计算结果分别是多少?(2分) d) 假定系统当前时间为12:08,4个窗口的计算结果分别是多少?(2分) e) 假定系统当前时间为12:10,4个窗口的计算结果分别是多少?(2分)