2019-2020-1期末
一、选择题(50分)
- 下面关于 MongoDB的说法,错误的是( )
A. MongoDB 是文档型数据库
B. MongoDB中,在每个collection创建时,默认会在_id域上创建一个唯一索引
C. MongoDB 利用共识协议实现自动故障恢复
D. MongoDB 数据库必须规范化到3NF
- MongoDB collection inventory 中有如下文档:
   { item: "journal", qty: 25, size: { h: 14, w: 21, uom: "cm" }, status: "A" }

   { item: "notebook", qty: 50, size: { h: 8.5, w: 11, uom: "in" }, status: "A" }

   { item: "paper", qty: 100, size: { h: 8.5, w: 11, uom: "in" }, status: "D" }

   { item: "planner", qty: 75, size: { h: 22.85, w: 30, uom: "cm" }, status: "D" }

   { item: "postcard", qty: 45, size: { h: 10, w: 15.25, uom: "cm" }, status: "A" }
下面的操作返回的结果是( )
db.inventory.find({
   status: "A",
   $and: [ { qty: { $lte: 50 } }, { item: /^p/ } ]
})
A. { item: "postcard", qty: 45, size: { h: 10, w: 15.25, uom: "cm" }, status: "A" }
B. { item: "notebook", qty: 50, size: { h: 8.5, w: 11, uom: "in" }, status: "A" }
{ item: "postcard", qty: 45, size: { h: 10, w: 15.25, uom: "cm" }, status: "A" }
C. { item: "journal", qty: 25, size: { h: 14, w: 21, uom: "cm" }, status: "A" }
{ item: "notebook", qty: 50, size: { h: 8.5, w: 11, uom: "in" }, status: "A" }
{ item: "postcard", qty: 45, size: { h: 10, w: 15.25, uom: "cm" }, status: "A" }
D. { item: "notebook", qty: 50, size: { h: 8.5, w: 11, uom: "in" }, status: "A" }
- MongoDB 创建(X,Y,Z)上的组合索引,下面哪种访问模式不会使用索引?( )
A. 用X筛选数据
B. 用Y,Z筛选数据
C. 用X,Y,Z筛选数据
D. 用X,Y筛选数据
- Raft 复制状态机的状态转换图如下所示,A,B,C三个状态是( )
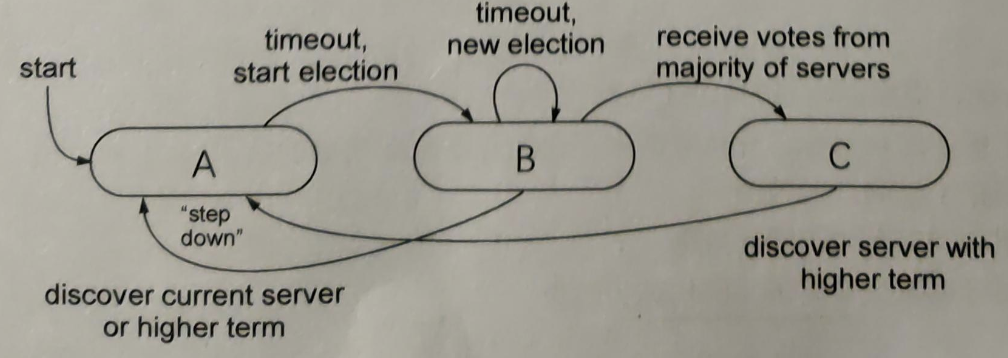
A. Leader, Follower, Candidate
B. Candidate, Follower, Leader
C. Follower, Leader, Candidate
D. Follower, Candidate, Leader
- 下面关于 Raft 协议的描述,错误的是( )
A. Raft 是一种共识协议,用于构建自动恢复的高可用系统
B. Raft 领导者(leader)会覆盖已被应用(apply)的日志以节省存储空间
C. 在任意一个 Raft任期(term)内,系统中最多会选出一个领导者(leader)
D. 如果一个 Raft节点在一个给定的序号(index)将一个日志应用(apply)到的复制状态机(state machine),那么任何其他 Raft 节点都不会将不同的日志应用(apply)到这个序号(index)
- 元组A,B位于服务器 r 上,元组C,D位于服务器 s 上,下面的事务需要两阶段提交的是( )
A. read A, write C
B. read A, write B
C. write C, write D
D. read B, read D
- 在ER图中有两个实体类A和B,实体类之间有一个联系。已知A和B的数据分别存放在Ra 和 Rb 两个关系表中,那么A和B的联系应该存放在哪里? ( )
A. 必须使用第三张关系表Rc存放两者的联系。
B. 当A和B之间为1:n的联系时,可以将联系存放在Ra中。
C. 当A和B之间为1:n的联系时,可以将联系存放在Rb中。
D. 当A和B之间为n:m的联系时,可以将联系存放在Ra中。
- 使用 SQL 语句进行分组检索时,为了去掉不满足条件的分组,应当( )
A. 使用WHERE 子句
B. 在 GROUP BY 后面使用HAVING 子句
C. 先使用 WHERE子句,再使用 HAVING 子句
D. 先使用 HAVING子句,再使用WHERE 子句
- 假设两张表A和B分别包含1000个元组和10000个元组,而内存可以容纳2000个元组。如果要连接A和B,使用哪种算法最划算?( )
A. 嵌套循环,A表为内循环
B. 嵌套循环,B表为内循环
C. 排序合并
D. 索引连接
-
下列关于ORM的作用描述错误的是( )
A. ORM 是为了解决面向对象与关系数据库存在的互不匹配现象的技术
B. ORM的作用在于提高开发效率
C. ORM 的作用在于提高代码运行效率
D. ORM 的使用可以减少数据访问层代码的数量
-
下面关于ORM 的说法正确的是( )
① 对象关系映射是对象与数据库的表之间的映射
② 对象关系映射是类与表之间的映射
③ 对象关系映射是类与表中的列之间的映射
④ 对象关系映射让类中的属性与表中的列产生映射关系
A. ①③
B. ①④
C. ②④
D. ③④
-
在进行数据库性能调优过程中,需要考虑数据库系统软件、硬件配置、网络环境等多方面因素。下列有关性能调优的说法,不符合事实的是( )
A. 修改某些频繁使用的SQL语句,提高其性能,可能会大幅度降低数据库 CPU 使用率
B. 数据库性能优化一般以更换服务器硬件为主要调优手段
C. 当数据库服务器磁盘IO出现写瓶颈时,可以考虑使用高速磁盘存储常用数据,低速磁盘存储不常用数据
D. 索引虽然可以提高某些查询的速度,但可能降低数据更新的速度
-
下列调优选项中可以减少查询语句执行时间的有( )
① 在查询所涉及的列上建合适的索引
② 更改表结构的设计,使得执行一些查询时不必进行多表连接操作
③ 重写SQL,调整其表达方式
④ 增加内存的缓冲区大小
⑤ 降低事务处理的隔离级别
A. 124
B. 134
C. 1234
D. 以上都是
-
索引能够加速对数据的访问,下列关于在某个关系R上,执行一个查询q(有相应的索引)访问的数据块个数描述正确的是( )
查询q的关系代数表示为 \(\sigma p(R)\)
其中:
p代表谓词
s代表谓词p的选择率
b代表一个数据块的大小(以字节为单位)
T(R)代表关系R包含的元组数
S(R)代表关系R中元组的平均大小(以字节为单位)
B(R)代表关系R包含的总块数
L代表读取索引需要访问的数据块个数
注:假设满足谓词p的元组均匀分布在表中
A. \(L + B(R)\)
B.$ L + (1 - (1-s)^{b/S(R)}) * B(R)$
C.$ L + (1 - s^{b/S(R)}) * B(R)$
D. \(L + s B(R)\)
-
关于OLTP与OLAP的比较,描述有误的一项是( )
A. OLTP 面向应用,事务驱动;OLAP 面向分析,分析驱动
B. OLTP 针对综合数据,OLAP针对细节数据
C. OLTP 要求吞吐率高,OLAP要求响应时间合理
D. OLTP 使用当前数据,OLAP使用历史数据
-
OLAP 技术的核心是( )
A. 多维分析
B. 人机交互
C. 快速响应
D. 机器学习
-
OLAP 的基本分析功能有( )
①切片 ②切块 ③钻取 ④旋转 ⑤上卷
A. 123
B. 134
C. 135
D. 以上都是
-
关于 PostgreSQL 提供的备份与恢复方式,描述有误的一项是( )
A. 使用文件系统级别的备份方式必须关闭数据库
B. pg_dump 运行时,对数据库的更新不会被转储
C. 可以通过连续的备份WAL文件归档来实现连续的数据库备份
D. 基于PITR 的恢复只能将数据库恢复到离故障最近的正常状态
-
关于数据库备份与复制操作,描述有误的一项是( )
A. 复制是将不再使用的旧数据从数据库中移除,并转移到线下设备
B. 复制需要随时保证多份数据的一致性,备份只是定期保持多份数据的一致性
C. 备份可以用于处理更多错误,例如撤销已提交的事务
D. 复制和备份都可以起到容错容灾的作用
-
关于 redo 和 undo日志,描述有误的一项是( )
A. 使用 redo 日志,数据不必在commit的时候落盘
B. 使用 undo 日志,数据必须要在commit之前落盘
C. 使用 redo 日志,日志必须先于数据落盘
D. 使用 undo 日志,日志不必先于数据落盘
-
以下关于事务 ACID 的说法,哪一项是错的?( )
A. A确保一个事务是一个不可分割的操作。
B. C确保并发的事务之间不相互干扰。
C. I由数据库系统的并发控制机制保证。
D. D由数据库的持久化机制保证。
-
为什么事务过长会导致性能问题?( )
A. 因为长事务的I/O代价通常更高。
B. 因为长事务的持锁时间长,导致并发度低。
C. 因为长事务的计算复杂度通常更高。
D. 长事务并不比短事务的性能差。
-
关于两阶段锁的说法,哪一项是错的?( )
A. 两阶段锁要求在锁全部加上之前不能释放任何锁。
B. 两阶段锁可以确保可串行化。
C. 两阶段锁可以确保死锁不会发生。
D. 实现 Read Committed的隔离级别不需要实施两阶段锁。
-
对 CAP 理论的合理阐释是( )
A. C、A、P三种性质无法同时实现,只能在CA、CP、AP之中选择一种。
B. C、A、P三种性质无法同时实现;当P发生时,我们无法兼顾C和A。
C. 传统的SQL数据库选择了CP。
D. 新兴 NoSQL数据库选择了AP。
-
关于 Linearizability 和 Serializability 的区别,以下哪种说法有误?( )
A. 从概念上讲,满足Linearizability 就一定满足 Serializability。
B. Linearizability 通常用于定义操作的原子性,而Serializability 通常用于定义事务之间的隔离性。
C. 两阶段锁可以用于实现Serializability。
D. 两阶段锁不能用于实现Linearizability。
二.简答题(15分)
请根据以下四张表,使用SQL语句完成以下查询:
Table 1. 学生表 Student (SId, Sname, Sage, Ssex)
| SId | Sname | Sage | Ssex |
|---|---|---|---|
| 1 | 赵雷 | 1990/1/1 | 男 |
| 2 | 钱电 | 1990/12/21 | 男 |
| 3 | 孙风 | 1990/12/20 | 男 |
| 4 | 李云 | 1990/12/6 | 男 |
| 5 | 周梅 | 1991/12/1 | 女 |
| 6 | 吴兰 | 1992/1/1 | 女 |
| 7 | 郑竹 | 1989/1/1 | 女 |
| 9 | 张三 | 2017/12/20 | 女 |
| 10 | 李四 | 2017/12/25 | 女 |
| 11 | 李四 | 2012/6/6 | 女 |
| 12 | 赵六 | 2013/6/13 | 女 |
| 13 | 孙七 | 2014/6/1 | 女 |
| (SId学生编号, Sname 学生姓名, Sage 出生年月, Ssex 学生性别) |
Table 2. 课程表 Course (CId, Cname, TId)
| CId | Cname | TId |
|---|---|---|
| 1 | 语文 | 2 |
| 2 | 数学 | 1 |
| 3 | 英语 | 3 |
| (CId课程编号, Cname 课程名称, TId 教师编号) |
Table 3. 教师表 Teacher (TId, Tname)
| TId | Tname |
|---|---|
| 1 | 张国 |
| 2 | 李芳 |
| 3 | 王仁一 |
| (TId教师编号, Tname 教师姓名) |
Table 4. 成绩表 SC (SId, CId, score)
| SId | CId | score |
|---|---|---|
| 1 | 3 | 99 |
| 2 | 1 | 70 |
| 2 | 2 | 60 |
| 2 | 3 | 80 |
| 3 | 1 | 80 |
| 3 | 2 | 80 |
| 3 | 3 | 80 |
| 4 | 1 | 50 |
| 4 | 2 | 30 |
| 4 | 3 | 20 |
| 5 | 1 | 76 |
| 5 | 2 | 87 |
| (SId学生编号, CId课程编号, score 分数) |
(1) 查询至少有一门课与学号为”01“的同学所学相同的同学的信息
(2) 查询两门及以上不及格课程的同学的学号,姓名及其课程的平均成绩,列出sid, sname,平均成绩
(3) 按平均成绩从高到低显示所有学生的所有课程的成绩以及平均成绩(avscore),列出sid, cid, score, avscore (平均成绩)
三.简答题(20分)
考虑以下场景:一个同城活动网站。用户注册后,将个人信息提交给网站。网站利用个人信息给每个人推荐活动,比如郊游、公益活动、读书会、火锅等等。每个用户可以在网站发起活动,指定活动的标题、时间、地点、类别和内容。一旦活动创建成功,其他用户就可以浏览活动的内容并报名。报名截止后,活动的发起人可以选择合适的报名者,给对方发接收函。收到接收函的用户一旦确认就成为活动参与人。之后,活动发起人可以随时给参与人发送通知,确定活动的参与细节。活动开始后,发起人可以记录活动情况(包括文字和照片),供所有用户了解。活动结束后,参与人可以给活动打分、写评价。
请分别使用文档模型和关系模型设计这个网站的数据库模式,并对设计做适当解释。
四.简答题(15分)
一个大规模应用使用分布式SQL数据库管理用户的积分。该应用允许用户相互之间转积分,即扣掉用户A的n分并为用户B增加n分。我们可以用单个事务确保转积分过程的原子性。然而,由于该应用使用了分布式数据库,A和B的积分记录可能分布在不同节点上,会导致分布式事务,性能难以保障。请问:怎么设计转积分过程的逻辑,既能避免分布式事务,又能实现最终的原子性(即便发生系统故障,任意一个转积分操作要么完全成功,要么完全撤销;并且,多个转积分操作相互不干扰)?