lab1实验报告
| 课程名称:当代人工智能 | 年级:22级 | 上机实践成绩: |
|---|---|---|
| 指导教师:李翔 | 姓名:郭夏辉 | 学号:10211900416 |
| 上机实践名称:文本分类 | 上机实践日期:2023年9月13日 | 上机实践编号:No.1 |
| 组号:1-416 | 上机实践时间:2023年9月13日 |
一、实验目的
本次实验给了一个数据集,其中包含标签(0-9)和英文文本,我们要使用其训练几种人工智能模型,然后再利用训练出来的模型去预测给出的测试集(只有英文文本)的标签。
二、实验流程
- 将训练数据自行划分训练集和验证集(固定划分或多折交叉验证)
- 将文本映射成向量(TF-IDF/Word2vec/Fasttext/Glove/Bert/XLNet)
- 通过训练集训练分类器(SVM/MLP/TextCNN/TextRNN/Bert...)
注意事项:
- 测试集只提供texts,将最终预测结果保存为results.txt文件。(results.txt文件的格式要与submit_sample.txt文件一致)
- 必须要实现的四种方法:逻辑回归/SVM/MLP/决策树
- 不能使用额外训练数据训练模型。
三、理论学习
支持向量机SVM
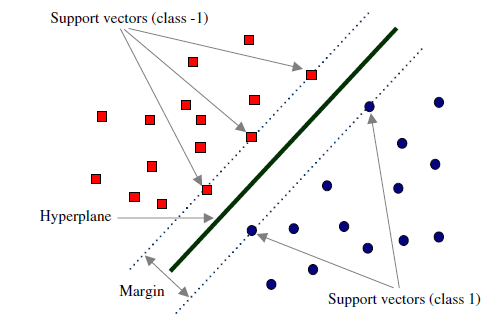
在机器学习中,支持向量机 (support vector machine,简称为SVM)是在分类与回归分析中分析数据的监督式学习模型与相关的学习算法。给定一组训练实例,每个训练实例被标记为属于两个类别中的一个或另一个,SVM训练算法建立一个将新的实例分配给两个类别之一的模型,使其成为非概率二元线性分类器。SVM模型是将实例表示为空间中的点,这样映射就使得单独类别的实例被尽可能宽的明显的间隔分开。然后,将新的实例映射到同一空间,并基于它们落在间隔的哪一侧来预测所属类别。
除了进行线性分类之外,SVM还可以使用所谓的核技巧有效地进行非线性分类,将其输入隐式映射到高维特征空间中,SVM找到的分割超平面具有更好的鲁棒性。支持向量机的主优化问题为凸优化问题,满足强对偶性,即主优化问题可以通过最大化对偶函数来求解。对偶函数是一个凹函数,因此最大化对偶函数是一个凸优化问题,可以通过多种凸优化方法来进行求解。
逻辑回归
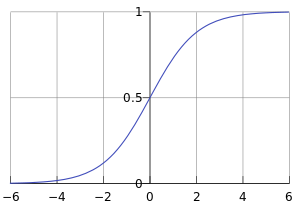
逻辑回归(逻辑斯谛斯谛回归,Logistic regression)是一种用于解决二分类(0 / 1)问题的机器学习方法,用于估计某种事物的可能性。Logistic回归是一种概率模型,其通过使用 Logistic 函数来将一个实数值映射到 [0, 1] 之间。Logistic 回归的本质是:假设数据服从这个分布,然后使用极大似然估计做参数的估计。Logistic 回归采用交叉熵作为损失函数,并使用梯度下降法来对参数进行优化。
多层感知机MLP
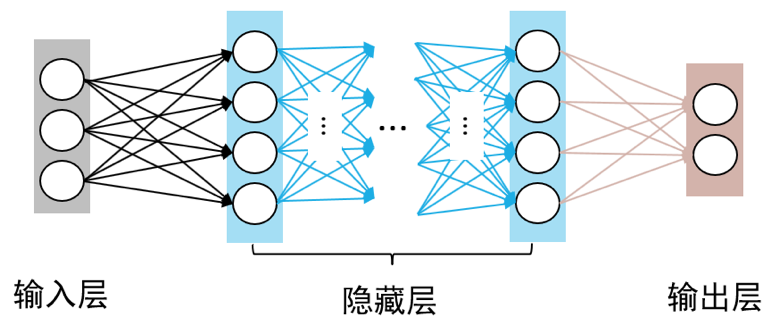
多层感知机(Multilayer Perceptron)又称为前向全连接神经网络(Feed-forward Fully-Connected Neural Network)是一种前向结构的人工神经网络,映射一组输入向量到一组输出向量。MLP可以被看作是一个有向图,由多个的节点层所组成,每一层都全连接到下一层。除了输入节点,每个节点都是一个带有非线性激活函数的神经元(或称处理单元)。反向传播算法是一种监督学习方法,常被用来训练MLP。多层感知器遵循人类神经系统原理,学习并进行数据预测。它首先学习,然后使用权重存储数据,并使用算法来调整权重并减少训练过程中的偏差,即实际值和预测值之间的误差。
多层感知的基本结构是三层:输入层,隐藏层和输出层,输入元素和权重的乘积被馈给具有神经元偏差的求和结点,使得MLP具备了快速解决复杂问题的优势。并且,MLP是感知器的推广,克服了感知器不能对线性不可分数据进行识别的弱点。
决策树
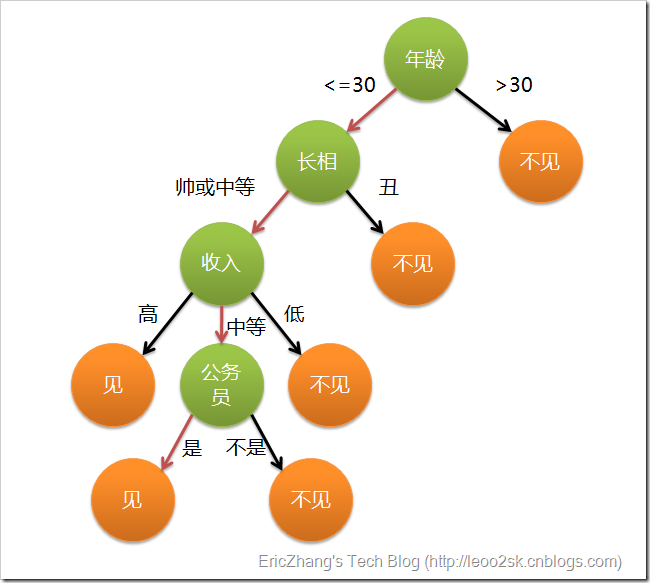
决策树是一种常见的监督学习算法,用于分类和回归问题。在分类问题中,叶子节点代表不同的类别,而在回归问题中,叶子节点包含数值预测。它模拟了决策过程,通过一系列规则和条件将数据点划分为不同的类别或值。决策树是一个层级结构,从根节点开始,通过一系列内部节点最终到达叶子节点。每个节点表示一个特征或属性上的测试条件,而每个边表示一个测试条件的结果。
在构建决策树时,算法选择最佳的特征和分裂条件,以将数据划分为不同的子集。这个选择通常基于信息增益、基尼不纯度、均方误差等评估指标。决策树的深度取决于数据和问题的复杂性。更深的树可以更好地拟合训练数据,但也容易过拟合。
TextCNN
在Word2Vec这样的词嵌入方法及相关的卷积方法之应用之后,Yoon Kim提出了文本分类的TextCNN方法。TextCNN对文本使用了自动的N-gram提取,将句子的词向量嵌入矩阵视为一个一维的特征图,通过使用多个不同大小的一维卷积核在词向量矩阵上做滑动,就可以获得句子中不同粒度上的语言特征。
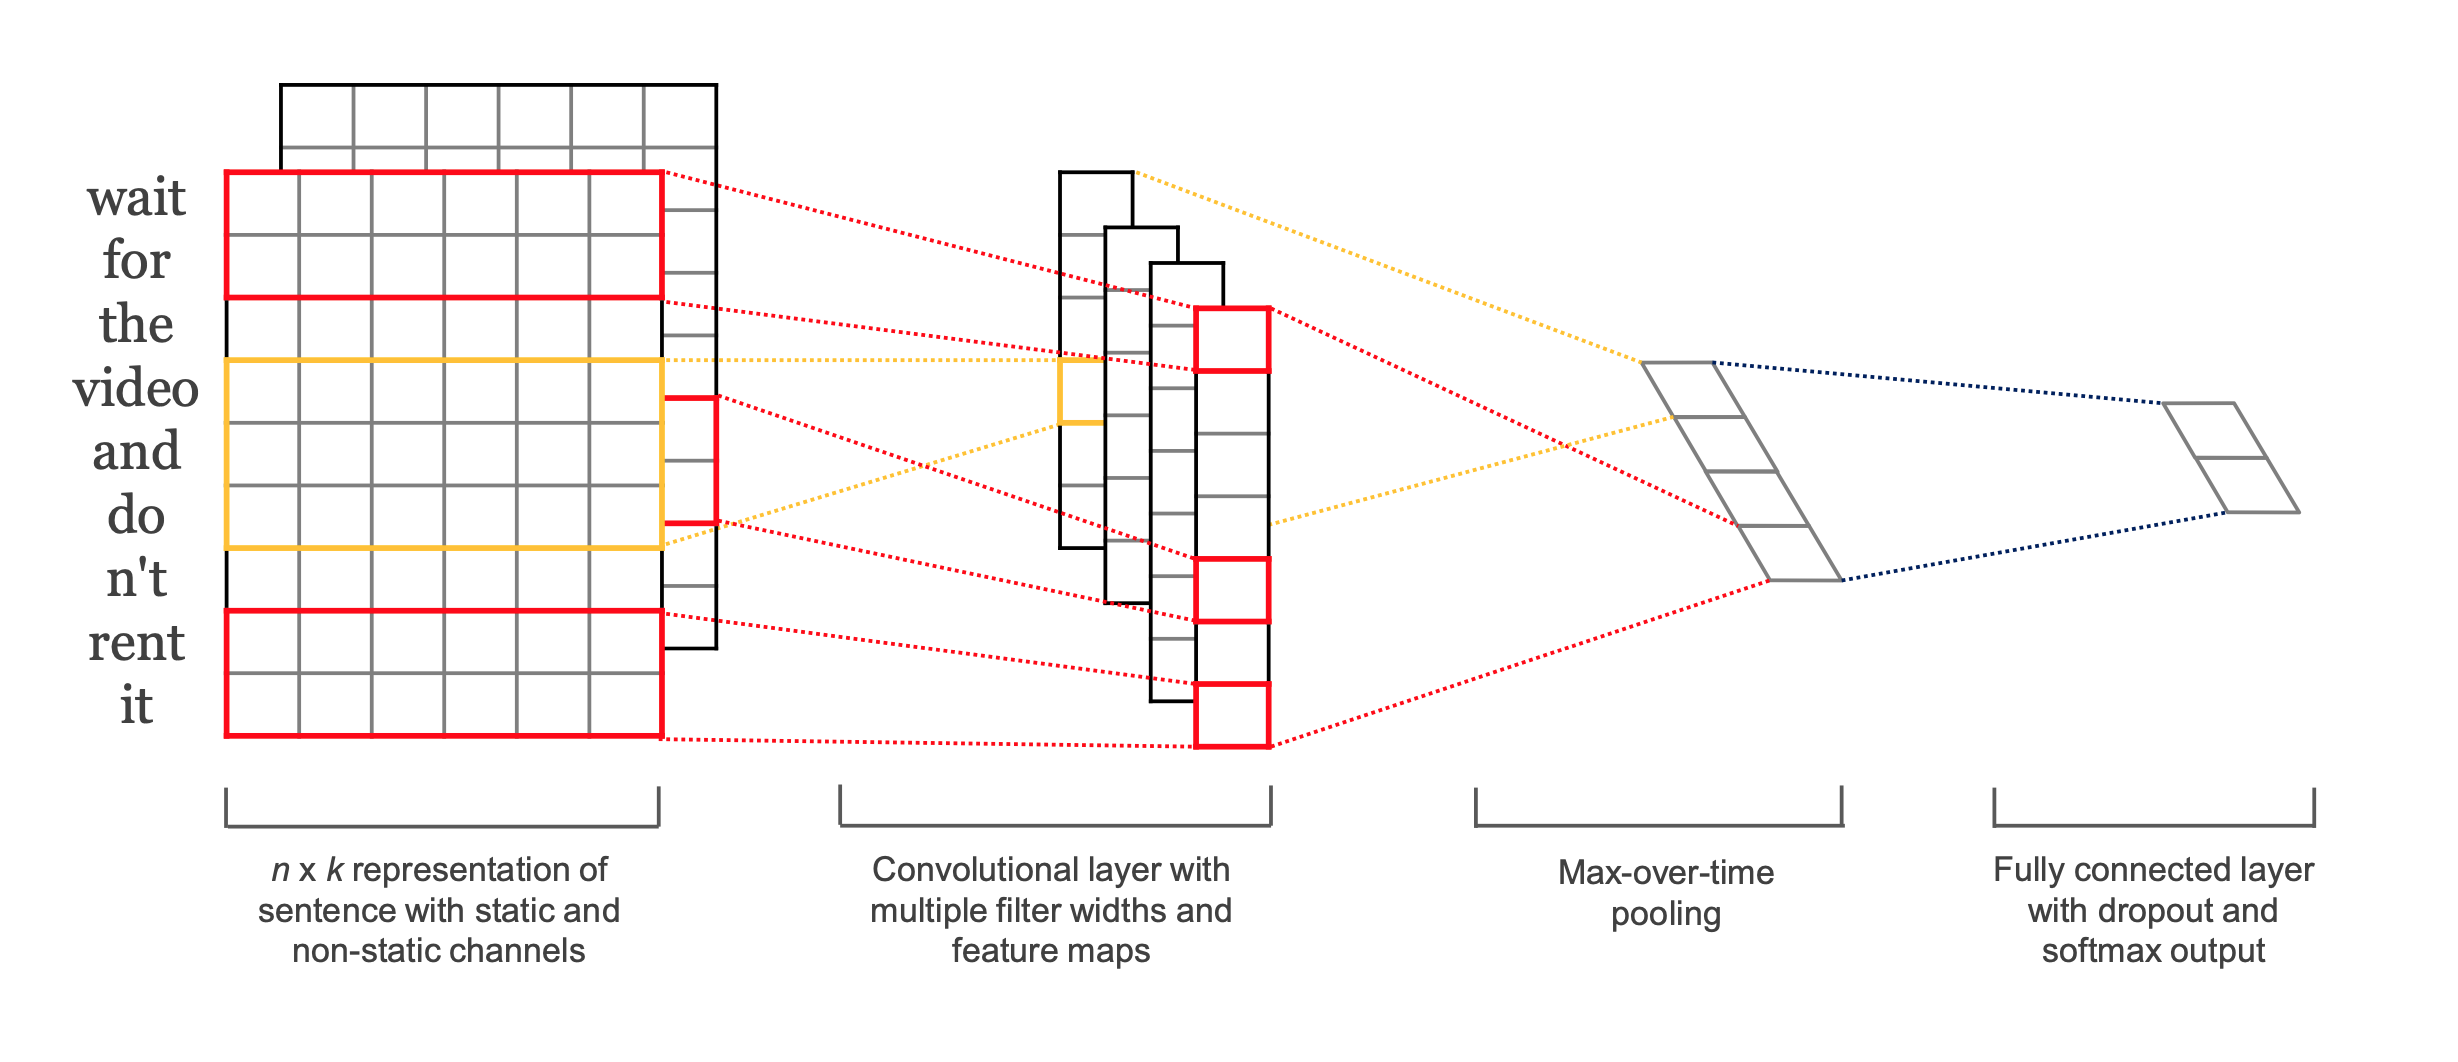
第一层将单词嵌入到低维矢量中。下一层使用多个过滤器大小对嵌入的单词向量执行卷积。接下来,将卷积层的结果最大池化为一个长特征向量,添加dropout正则,并使用softmax对结果进行分类。与传统图像的CNN网络相比, TextCNN 在网络结构上没有任何变化(甚至更加简单了), 从图中可以看出TextCNN 其实只有一层卷积,一层max-pooling, 最后将输出外接softmax来n分类。
与图像当中CNN的网络相比,TextCNN最大的不同便是在输入数据的不同:图像是二维数据, 图像的卷积核是从左到右, 从上到下进行滑动来进行特征抽取。自然语言是一维数据, 虽然经过word-embedding 生成了二维向量,但是对词向量做从左到右滑动来进行卷积没有意义。TextCNN最大优势网络结构简单 ,在模型网络结构如此简单的情况下,通过引入已经训练好的词向量依旧有很不错的效果。
四、正式实验
1.数据的预处理
最开始肯定要读入相应的文件。有一个需要注意的地方是test.txt文件第一行是列名,可以被扔掉。读入文件之后,我将其转化为了DataFrame形式方便之后的实验。
由于我是按行读取的文件,每一行都有正常语句会出现的标点符号、停顿词。为了排除这些干扰因素对后续分类实验的影响,我应该先消除它们:
nltk.download('stopwords')
stemmer = PorterStemmer()
dataset_df['raw'] = dataset_df['raw'].apply(lambda x: " ".join([stemmer.stem(i) for i in re.sub("[^a-zA-Z]", " ", x).split() if i not in stopwords.words("english")]).lower())
2.文本向量化
仅仅是一大堆单词并不能展开实验,我们需要将其向量化才能开始训练。转化为向量有很多种方法,我选择的是TF-IDF和Word2Vec。
2.1TF-IDF
TF-IDF是一种针对关键词的统计分析方法,用于评估一个词对一个文件集或者一个语料库的重要程度。一个词的重要程度跟它在文章中出现的次数成正比,跟它在语料库出现的次数成反比。
其中TF指的是某词在文章中出现的总次数,该指标通常会被归一化定义为TF=(某词在文档中出现的次数/文档的总词量)
IDF逆向文档频率=log(语料库中文档总数/包含该词的文档数+1),+1的原因是避免分母为0。
TFIDF=TFxIDF,TFIDF值越大表示该特征词对这个文本的重要性越大。
为了方便实验,我直接采用sklearn库中的TFIDFVectorizer方法实现了TF-IDF算法,其中stop_words='english'消除了助词,语气词等停用词,可以提高算法的精确性:
# 文本向量化
tv = TfidfVectorizer(stop_words='english')
X_train_tfidf = tv.fit_transform(dataset_df['raw'])
X_test_tfidf = tv.transform(testdata_df['text'])
y = dataset_df['label']

X_test_id = np.expand_dims( np.array(range(0,len(testdata_df)) ), axis=1)
2.2Word2Vec
word2vec可以在百万数量级的词典和上亿的数据集上进行高效地训练,它得到的词向量可以很好地度量词与词之间的相似性。''一个词的含义可以由它的上下文推断得出''。相较于传统NLP的高维、稀疏的表示法(One-hot Representation),Word2Vec训练出的词向量是低维、稠密的。Word2Vec利用了词的上下文信息,语义信息更加丰富.
nltk.download('punkt')
#Word2Vec
# 提取文本数据和标签
texts = [entry['raw'].lower() for entry in dataset1 ]
labels = [entry['label'] for entry in dataset1]
sentences = [word_tokenize(text) for text in texts] # 分词

modelw2v = Word2Vec(sentences, vector_size=160, window=5, min_count=1 ,sg=0)
words = modelw2v.wv.index_to_key
word_index = {word: idx for idx, word in enumerate(words)}
# 转换文本数据为词向量序列
max_sequence_length = 160
text_sequences = []
for text in texts:
    sequence = [word_index.get(word, 0) for word in word_tokenize(text)]
    text_sequences.append(sequence)
# 填充文本序列
text_sequences = keras.preprocessing.sequence.pad_sequences(text_sequences, maxlen=max_sequence_length)
3.各模型的初次尝试
在sklearn库中,有本次实验必需的四种模型(SVM,逻辑回归,决策树,MLP)封装好的类。我只用正确地调用相关的方法就能对各模型初次尝试。
3.1训练集和验证集的分割
这里我要将实验给到的数据集进行分割——分割为训练集和验证集。在分割之后,使用训练集去训练对应的模型;训练完成之后采用验证集来测试训练的得分。这个分割我直接使用了sklearn库train_test_split方法,采用的是固定分割的方式,并且所取得验证集在整个数据集中的比例是五分之一:
X_train, X_test, y_train, y_test = train_test_split(X_train_tfidf, y, test_size=0.2, random_state=42)
random_state:随机数种子。指定一个固定的数值后,每次运行程序得到的随机结果都是相同的。
test_size:验证集在整个数据集中所占的比例。
3.2具体的尝试过程
划分了训练集和验证集,只用正确调用就能训练四种模型了。具体的代码相似度比较高且乏善可陈,我就不放到这里了,在我的代码文件中可以找到。以下只有SVC(SVM classifier)的小小尝试代码:
modelSVM = SVC()
modelSVM.fit(X_train, y_train)
score = modelSVM.score(X_test, y_test)
print("Model score:", score)
其实就是先设置了模型,然后让这个模型去被训练数据和训练数据的标签训练(fit),加下来再去验证集上看看对了多少,给出一个准确度的得分。
3.3MLP的手动实现
对于MLP来说,助教给出了一个标准化的模板,使用的是Torch.我也模仿着写了一下:
# 转换为torch tensor
X_train_tfidf1 = X_train.toarray()
X_test_tfidf1 = X_test.toarray()

# 训练集
X_train_tensor = torch.tensor(X_train_tfidf1, dtype=torch.float32)
y_train_tensor = torch.tensor(y_train.values, dtype=torch.long)

# 验证集
X_test_tensor = torch.tensor(X_test_tfidf1, dtype=torch.float32)
y_test_tensor = torch.tensor(y_test.values, dtype=torch.long)

# 定义MLP模型
class MLP(nn.Module):
    def __init__(self, input_dim, hidden_dim, output_dim):
         super(MLP, self).__init__()
         self.fc1 = nn.Linear(input_dim, hidden_dim)
         self.fc2 = nn.Linear(hidden_dim, output_dim)
         self.relu = nn.ReLU()

    def forward(self, x):
         x = self.relu(self.fc1(x))
         x = self.fc2(x)
         return x

# 设置超参数
input_dim = X_train_tfidf1.shape[1]
hidden_dim = 100
output_dim = 10 # 十分类
learning_rate = 1e-4
epochs = 300

# 实例化模型、损失和优化器
modelMLP1 = MLP(input_dim, hidden_dim, output_dim)
criterion = nn.CrossEntropyLoss() # 损失函数:交叉熵
optimizer = optim.Adam(modelMLP1.parameters(), lr=learning_rate)

# 训练模型
for epoch in range(epochs):
    # 正向传播
    outputs = modelMLP1(X_train_tensor)
    loss = criterion(outputs, y_train_tensor)

    # 反向传播
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    if (epoch + 1) % 20 == 0:
        print(f"Epoch {epoch+1}/{epochs}, Loss: {loss.item():.4f}")

# 测试模型
with torch.no_grad():
    predictions = modelMLP1(X_test_tensor)
    _, predicted = torch.max(predictions, 1)
    accuracy = (predicted == y_test_tensor).sum().item() / y_test_tensor.size(0)
    print(f"Test Accuracy: {accuracy*100:.2f}%")
然后我来解析一下这个手写的MLP模型。
首先,我把TF-IDF向量化的训练和测试数据乃至标签都转化为PyTorch张量(tensor)。然后,我定义了一个MLP模型,这个模型含有全连接层和激活函数ReLU,定义了交叉熵作为损失函数,实例化了优化器为Adam,用于更新模型参数。
在正式的训练过程中,每次迭代都包含三个步骤:1.正向传播:将输入数据通过模型前向传播,得到模型的预测结果。2.计算损失:使用交叉熵损失函数计算预测结果与真实标签之间的差异。3.反向传播:通过优化器反向传播,计算梯度并更新模型参数。
然后这里我考虑了一个问题,这个Adam优化器有什么好的呢?它结合了动量(Momentum)和自适应学习率调整的特性。Adam根据每个参数的历史梯度信息来自适应地调整学习率。这意味着在训练过程中,不同参数可以具有不同的学习率,有助于更快地收敛和更稳定的训练。Adam还包括动量的概念,可以在训练过程中克服局部极小值,并加速收敛。除了Adam我还可以使用什么优化器呢?我就以SGD为例来聊一聊。它使用的方法是随机梯度下降,也是最简单的优化器,通常需要更多的训练周期才能收敛。
3.4TextCNN的实现
本着学习的态度,虽然我并不是很熟悉,但是也简单在这个实验中实现了一下TextCNN,如下所示。
3.4.1 数据的转化
word2vec预训练了词向量,利用训练之后的词向量参数初始化输入层,反向传播仍能继续优化输入层的参数,否则TextCNN的输入层是通过赋随机值的方法进行初始化的,这不利于训练的开展。而且在前面我也提到了,TextCNN对于输入数据有着额外的要求:网络在初始化时,如果每个词的语义关系很明确,网络才能够快速找出合适的分类特征。因此,这里我采用的是Word2Vec后的词向量作为TextCNN的训练和验证数据:
dataset1 = []
with open('train_data.txt', 'r', encoding='utf-8') as file:
    for line in file:
        try:
            entry = json.loads(line)
            dataset1.append(entry)
        except json.JSONDecodeError as e:
            print(f"Error parsing JSON: {e}")
            continue

nltk.download('punkt')

#Word2Vec
# 提取文本数据和标签
texts = [entry['raw'].lower() for entry in dataset1 ]
labels = [entry['label'] for entry in dataset1]
sentences = [word_tokenize(text) for text in texts] # 分词

modelw2v = Word2Vec(sentences, vector_size=160, window=5, min_count=1 ,sg=0)
words = modelw2v.wv.index_to_key
word_index = {word: idx for idx, word in enumerate(words)}
# 转换文本数据为词向量序列
max_sequence_length = 160
text_sequences = []
for text in texts:
    sequence = [word_index.get(word, 0) for word in word_tokenize(text)]
    text_sequences.append(sequence)
# 填充文本序列
text_sequences = keras.preprocessing.sequence.pad_sequences(text_sequences, maxlen=max_sequence_length)
数据分割:
X_train1, X_test1, y_train1, y_test1 = train_test_split(text_sequences, labels, test_size=0.2, random_state=42)
3.4.2主程序
y_train1 = np.array(y_train1).reshape(-1, 1)
y_test1 = np.array(y_test1).reshape(-1, 1)
modelTextCNN = keras.Sequential([
    Embedding(input_dim=len(word_index), input_length=max_sequence_length,output_dim=160),
    Conv1D(128, 5, activation='relu'),
    GlobalMaxPooling1D(),
    Dense(10, activation='softmax')
])

modelTextCNN.compile(loss='sparse_categorical_crossentropy', optimizer='adam', metrics=['accuracy'])

# 训练模型
epochs = 10
modelTextCNN.fit(X_train1, y_train1, epochs=epochs)

loss, score = modelTextCNN.evaluate(X_test1, y_test1)
print("Model score:", score)
模型modelTextCNN包括:
- 嵌入层(Embedding):将文本数据转化为稠密向量表示。input_dim表示词汇表的大小;input_length表示输入序列的最大长度,这里我采用的是max_sequence_length,即160,输入向量的最大维度;而
output_dim表示嵌入向量的维度,这个还是160. - 卷积层(Conv1D):捕捉文本数据的局部特征。它有128个滤波器,每个滤波器的宽度是5,激活函数是ReLU。
- 全局最大池化层(GlobalMaxPooling1D):从卷积层的输出中提取最重要的特征。
- 全连接层(Dense):输出维度为10,对应的是十分类任务。激活函数为 softmax。
然后在配置模型时,采用的损失函数是稀疏分类的交叉熵(sparse_categorical_crossentropy)。这里有一个小坑,就是标签为one-hot形式时,才能使用categorical_crossentropy作为损失函数;而这里我并没有这样去用,最后一层应该使用softmax,损失函数要用sparse_categorical_crossentropy。在这里我小小卡了一阵子,一直碰到ValueError: logits and labels must have the same shape报错。
优化器依然选择的是Adam,评估指标是准确度(accuracy),迭代轮次10轮(主要是迭代一轮的时间消耗太大了,我想尽快看到结果)。
3.5各模型准确率初次小对比
在初次尝试了各模型之后,我来汇总一下各模型的准确率吧(经供参考):
| 模型 | SVM | 逻辑回归 | 决策树 | MLP(sklearn) | MLP(自己实现) | TextCNN |
|---|---|---|---|---|---|---|
| 准确率 | 0.94625 | 0.95 | 0.779375 | 0.96 | 0.9331 | 0.921875 |
可以看到,除了决策树,其他各模型的准确率还是较高的,都超过了90%。
4.参数调整
我认为本次实验最耗时,也是最主要的工作就是参数调整了。我的参数调整过程围绕sklearn的GridSearchCV方法。
4.0以SVM为例,测试不同的折数对训练的影响
在一切开始之前,我想先来看一下不同的划分比例(折数)对训练的影响。以SVM为例,面向相同的数据集,我选择了一部分为验证集(比例为testsize),另外一部分作为训练集:
testsvmfold = []
for testsize in [0.1,0.2,0.3,0.4,0.5,0.6,0.7,0.8]:
    X_train2, X_test2, y_train2, y_test2 = train_test_split(X_train_tfidf, y, test_size=testsize, random_state=42)
    modelSVMi = SVC(kernel='linear', C=2,tol=0.0001)
    modelSVMi.fit(X_train2, y_train2)
    scorei = modelSVMi.score(X_test2, y_test2)
    print(f"test size={testsize} model score:{scorei}")
    testsvmfold.append(scorei)
结果如下图所示:
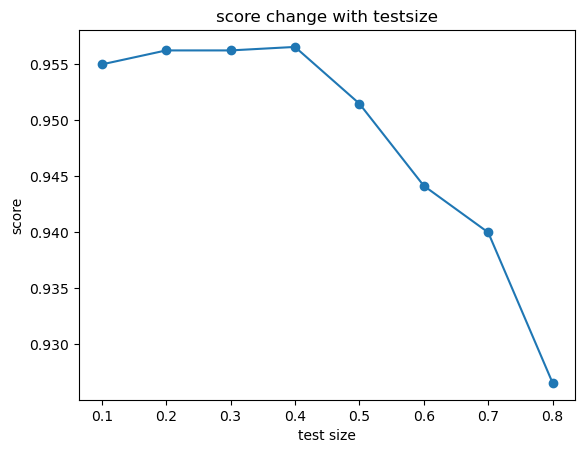
可以看到,随着验证集比例的扩大,最开始模型的训练准确率略微上升,之后急剧下滑。这个原理其实很好理解——过小比例的验证集,过大比例的测试集,可能造成模型的过拟合,准确率不佳;但是如果过大比例的验证集,过小比例的训练集,可能造成模型的训练并不充分,同样准确率不佳。而且,训练集的不充分所带来的影响要比验证集不充分更显著。
4.1 SVM
SVM的拟合过程是在特征空间中找到一个最优的超平面。它的关键超参数包括C、kernel、gamma等,它们分别指的是函数的惩罚系数(用来平衡分类间隔和错分样本)、核函数、核函数的系数。
其实SVM还有一个超参数就是tol,即SVM停止迭代的精度。为了避免反复地迭代,增大搜索速度,我这里的参数搜索网络tol设置为了统一值1e-4。
这个C值,即惩罚系数,如果太大则会倾向于使训练样本的分类准确度尽可能高,有较大程度的过拟合;如果太小,过于容忍错误分类导致模型无法有效地纠正噪声,有较大程度的欠拟合。
核函数我的选择就是常见的linear和听说效果特别好的高斯核函数rbf.
本来我还打算去搜索一下合适的核函数系数呢,但是实际运行下来所花的时间实在是太长了,就放弃了。
一个有趣的现象
而且我还在训练时发现了一个很奇怪的现象:
# 参数网格
param_grid = {
    'tol': [1e-4], # 小于达到该误差项即停止训练
    'kernel': ['linear', 'rbf'],
    'C': [0.01,0.1,0.25,0.5,0.75,1,2,3,4,5,6,7,8,9,10]
}

# 网络搜索参数调优
grid = GridSearchCV(SVC(),param_grid,cv=5,scoring='accuracy',n_jobs=-1)
grid.fit(X_train_tfidf, y)

print("best params:", grid.best_params_)
print("best accuracy:", grid.best_score_)
训练结果是这样的:
best params: {'C': 2, 'kernel': 'linear', 'tol': 0.0001}
best accuracy: 0.900625
在训练后,把对应的超参数调入模型,采用StratifiedKFold和cross_val_score方法进行交叉验证,结果也是类似的:
kfold = StratifiedKFold(n_splits=5)
testSVM = SVC(kernel='linear', C=2,tol=0.0001)
score_svm = cross_val_score(testSVM, X_train_tfidf , y, cv=kfold, scoring='accuracy')
print(np.mean(score_svm))
结果:0.900625,是一样的。
但是如果打乱了训练集和验证集的选取(StratifiedKFold中shuffle=True),训练的准确率就明显升高了:
kfold = StratifiedKFold(n_splits=5,shuffle=True, random_state=42)
testSVM = SVC(kernel='linear', C=2,tol=0.0001)
score_svm = cross_val_score(testSVM, X_train_tfidf , y, cv=kfold, scoring='accuracy')
print(np.mean(score_svm))
结果:0.96175 显著地高于0.900625
在查阅了一些资料后,我得知了数据集的划分方式(包括是否进行随机洗牌)可以对模型的性能评估产生重要影响。默认情况下shuffle=False,每折的数据是按顺序划分的,由于数据在原始数据集(train_data.txt)中具有某种顺序性,那么每个折叠内的数据也会反映这种顺序性。这可能导致某些折叠内的数据分布与其他折叠不一致,进而影响模型的性能。
因此,我在GridSearchCV搜索参数时候,采用的应该是打乱之后的数据。这要用到StratifiedShuffleSplit方法:
# 参数网格
param_grid = {
    'tol': [1e-4], # 小于达到该误差项即停止训练
    'kernel': ['linear', 'rbf'],
    'C': [0.01,0.1,0.25,0.5,0.75,1,2,3,4,5,6,7,8,9,10]
}
adjustSVM = SVC()
cv_strategy = StratifiedShuffleSplit(n_splits=5, test_size=0.2, random_state=42)
grid = GridSearchCV(adjustSVM,param_grid,cv=cv_strategy,scoring='accuracy',n_jobs=-1)
grid.fit(X_train_tfidf, y)

print("best params:", grid.best_params_)
print("best accuracy:", grid.best_score_)
训练结果是这样的:
best params: {'C': 2, 'kernel': 'linear', 'tol': 0.0001}
best accuracy: 0.960875
与前面的结果相吻合。我在之后的参数搜索过程中,也用类似的方法划分训练集和验证集。
这里还有一个我想拿出来说的地方,就是GridSearchCV方法由n_jobs这一项参数。n_jobs指的是并行数,如果设置为-1,并行数就和CPU的核数一样了,这样电脑的性能就能被更好地释放出来了,可以显著提升搜索的速度(由于笔者电脑配置有限,即便如此参数搜索所消耗的时间还是很长)。
SVM的在不同kernel和C之下准确率变化折线图如下所示:
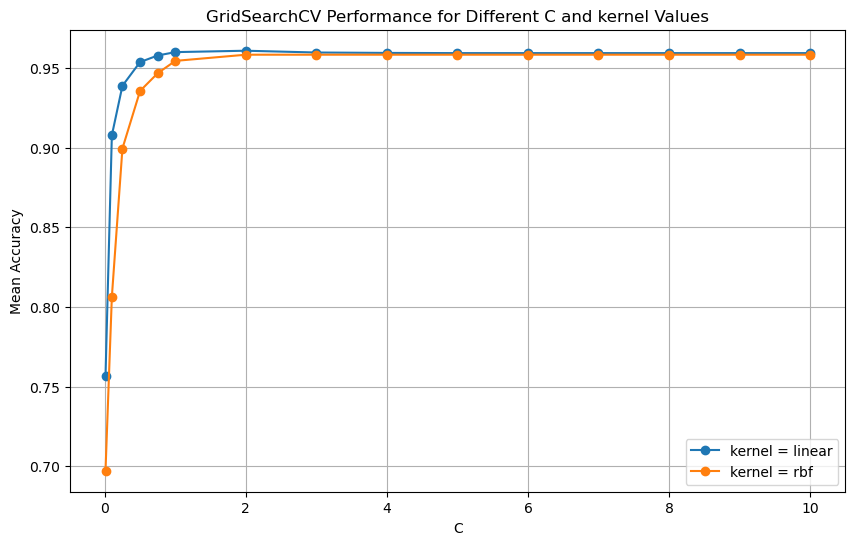
可以发现,在C较小时,两种kernel的准确率差异明显——linear明显好于rbf;但是在C较大时差距就没那么显著了。与此同时,随着C的提高,最开始准确率呈现一个急剧的增长趋势,但是在某个C之后,准确率保持平缓甚至下降了。
对交叉验证的学习
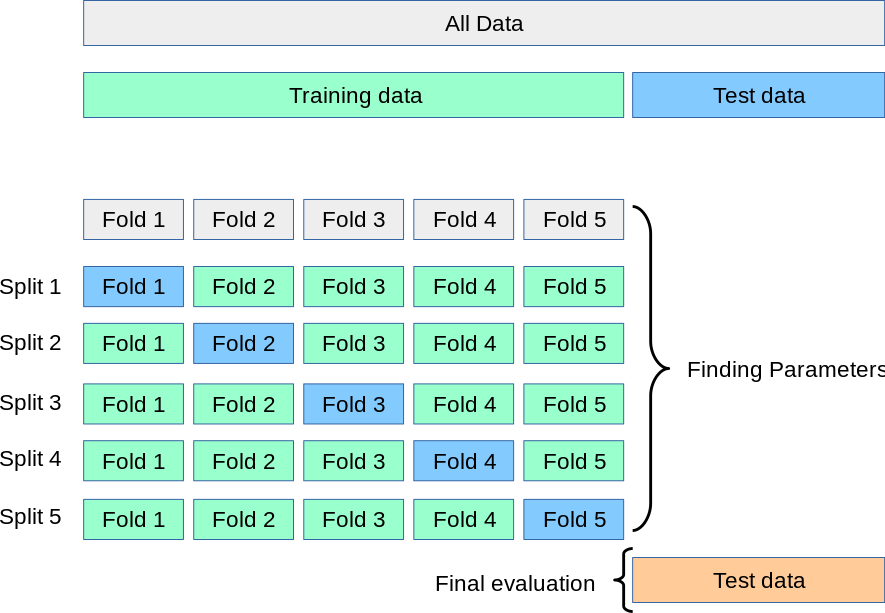
最开始我不太懂交叉验证是在干什么,查阅很多资料之后我终于懂了一些。
交叉验证通常有两种方法。一种为留一法,这种方法的问题在于每次验证集只有一个数据,若数据集规模很大,则需要循环迭代大量的次数。另一种更常用的方法被称为K-折交叉验证,其流程如上图所示。将所有数据集分成K份,每次取其中一份作为验证集,其他的作为训练数据,依次对模型进行训练和测试,得到K 个验证集上的评价指标。最后再对这K个结果取一下平均,便得到了模型准确率分数。
我刚刚碰到的那个有趣的小问题和这两种方法存在一些关联。
4.2 逻辑回归
逻辑回归的关键超参数包括C、penalty,slover等,它们分别指的是函数的正则化系数、惩罚项、求解器。
这里我默认使用的惩罚项是l2(主要是因为tf-idf得到的向量维数还是有点大的,使用L2正则化可以更好地帮助模型在训练过程中选择对任务有用的特征),tol与SVM调参同理,还是设置的是1e-4。与此同时,solver系统默认是Liblinear,较为适合小型数据集(毕竟这里语料向量的维度也就一万多),没必要使用Sag(随机梯度下降法)等,所以这里我没有去搜索其他的solver了。
采用类似的方法,我得到了逻辑回归的搜索结果:
best params: {'C': 20, 'penalty': 'l2', 'tol': 0.0001}
best accuracy: 0.9600000000000002
为了让准确率变化展现地更加明显,我将刻度对数化了:
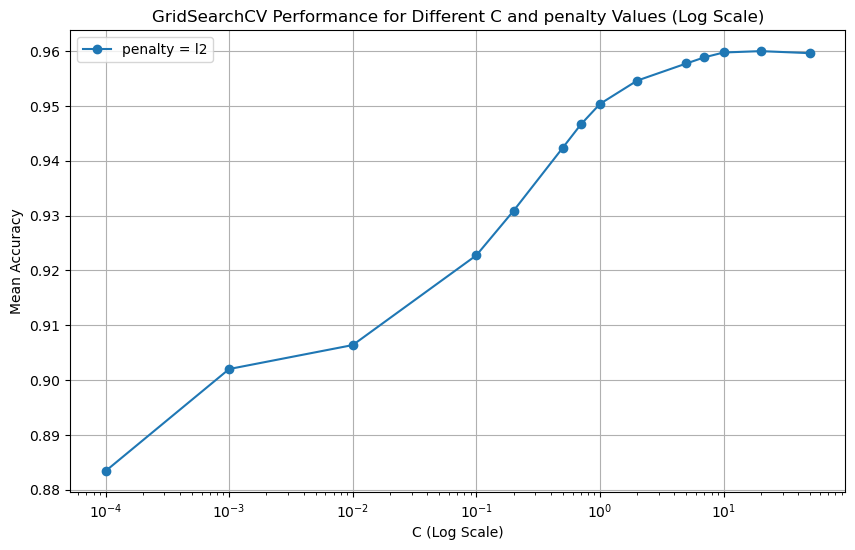
可以看到,C值较小时,正则化力度很强,模型复杂度过低,无法捕捉数据中的复杂关系,存在着较大程度的欠拟合。然后C值由极小增大时,正确率的提升是十分明显的。接下来,C值增大,正确率的提升平缓了许多,甚至存在下滑趋势,这是因为C较大时,正则化力度较弱,模型将尽量减小正则化项的影响,以最大程度地拟合训练数据,导致模型在训练数据上表现很好,但在未见过的数据上性能较差,存在着较大程度的过拟合。
4.3决策树
逻辑回归的关键超参数包括criterion、min_samples_leaf,min_samples_split等,它们分别指的是判定标准、最小叶节点样本数、最小样本分割数。
判定标准没什么好说的,一般就是gini(基尼不纯度)和entropy(信息熵).最小叶节点样本数指的是叶节点的最小样本数,如果一个叶节点上的样本数小于该值,会进行剪枝,合并叶节点。最小样本分割数指的是决策树节点分割的最小样本数,如果一个节点上的样本数小于该值,将不再分割。去搜索最小叶节点样本数和最小样本分割数,主要是为了剪枝。
我得到了决策树的搜索结果:
best params: {'criterion': 'gini', 'min_samples_leaf': 1, 'min_samples_split': 3}
best accuracy: 0.7821250000000001
准确率仅有78%,与模型初次尝试类似,决策树的表现还是十分糟糕的。
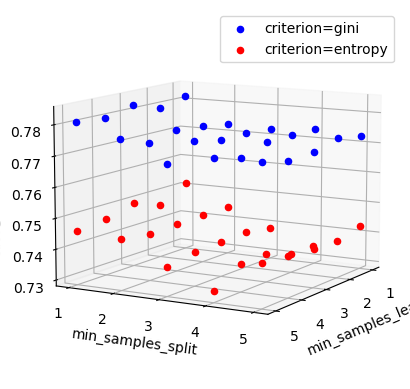
可以看到,采用gini作为判定标准的效果明显好于entropy.而且,其他因素相同时,伴随着min_samples_split的增长,准确率先增高后降低——如果min_samples_split设置得较小,模型将变得更灵活,但这也可能导致泛化性能下降;较大的min_samples_split则会限制节点分裂,对训练数据中的噪声和异常值更具鲁棒性,但是带来了更大程度的过拟合。其他因素相同时,伴随着min_samples_leaf的增长,我发现准确度并没有很大的变化,这可能是因为自己的min_samples_leaf取值范围较小吧,毕竟从理论上来说,小的min_samples_leaf值会导致树的叶节点更少,树的结构更简单,防止过拟合。
4.4 MLP
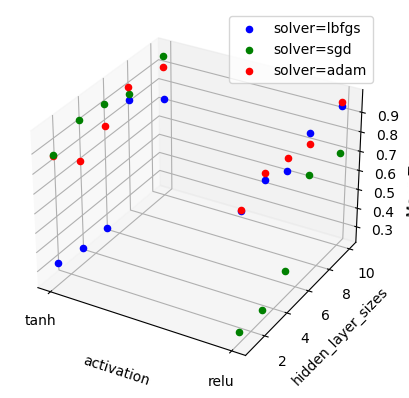
多层感知机的关键超参数包括activation(激活函数)、hidden_layer_sizes(隐藏层的大小),solver(优化器)、学习率、迭代次数等。
多层感知机训练所花的时间很长很长,为了简化搜索过程,我将参数搜索的网络精简化了。学习率我干脆就没搜索了,直接使用系统默认的。迭代次数(max_iter)我没有敢取太多,最多也就是500次。然后隐藏层的层数更是不敢多取,最多我也就取了10层。这个隐藏层的层数在官方给定的默认配置中是上百层,自己仅仅选择了最多10层显然是不太充分的。激活函数选择了tanh和relu,优化器选择了'lbfgs','sgd','adam'三种。
训练的结果是:
best params: {'activation': 'tanh', 'hidden_layer_sizes': 10, 'solver': 'adam'}
best accuracy: 0.96325
可以看到在我跑出来的结果中,采用tanh作为激活函数要比relu的效果好一些,虽然它们在隐藏层数较大时差距并不明显:
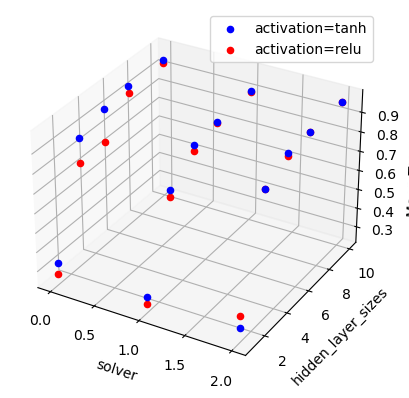
再看这张图,我们能看到随着隐藏层数的增大,模型的效果都是呈现升高趋势的。但是我的这个也并不够客观,因为选取的隐藏层大小实在是太小了,在隐藏层数过大时,不仅训练所花的时间超级多,而且还会出现很大程度的过拟合。
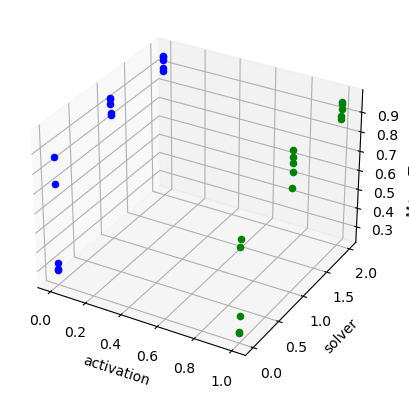
最后来看这张图,可以看到lbfgs作为优化器的效果是最差的,采用adam的效果要好一些。这与我之前对于adam的了解不谋而合。
4.5TextCNN
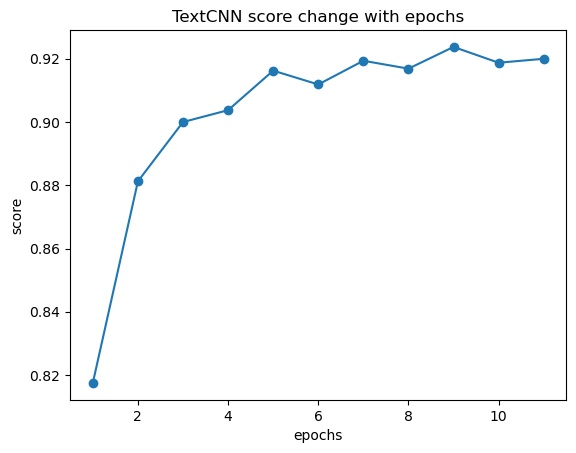
TextCNN由于我不是特别了解,所搜索的超参数只是迭代的轮次epochs。可以看到在轮次过小时,模型可能没有足够的机会学习训练数据的复杂模式,从而导致欠拟合,准确率较低;在轮次较大时,需要迭代很长的时间,模型的分类效果没有那么好。由于自己epochs还是没有跑到超级大的,所以过拟合情况没有很明显。
5.模型的比较、分析、选择
如果从结果论的角度出发,我先要比一下几种模型在训练集:验证集=4:1的情况下、打乱数据集数据才分训练集和验证集,采用我搜索到的最优参数之准确度:
| 模型 | SVM | 逻辑回归 | 决策树 | MLP | TextCNN |
|---|---|---|---|---|---|
| 准确率 | 0.96175 | 0.960000 | 0.782125 | 0.96325 | 0.92000 |
如果要从结果上来看,决策树无论是初次尝试还是调参之后,效果都是最差的。决策树虽然训练的结果简单且可解释,但是很容易生成过于复杂的树,过拟合训练数据。
SVM在高维数据中表现良好,适用于文本分类等问题。并且通过核技巧,SVM可以处理非线性分类问题。但是在使用非线性核函数时,训练时间较长,可解释性也并不像决策树一样直观。甚至我还看到网上说找到一个合适的核函数比较有技巧性,需要一个专业的调参师才行。
逻辑回归不仅简单,而且很高效。虽然对非线性关系的建模能力有限,但是从结果上来看,我们能发现它的准确率也是十分可观的。
MLP可以适应非线性关系这样的复杂的问题,可以逼近任何连续函数,因此在理论上非常强大。实际过程中证明了这一点,但是在训练过程中我比较心力交瘁——它的超参数训练,实在是太复杂了!我不得不简化搜索网络来提升效率,但这样就遗漏了很多更高效的参数。
TextCNN作为较新的技术,基于卷积神经网络,专门设计用于处理文本数据,在处理自然语言处理(NLP)任务中理应表现出色,特别是对于短文本和语言模式的捕捉。但是自己由于初次了解,掌握实在是有限,完成的TextCNN模型效果并不是很好。
折中、综合地考虑各方面因素,我本来选择了增大MLP的隐藏层数(就采用官方给定的默认参数),然后以此作为最终的模型。但是考虑到我还有很多更优的参数可能还没搜索到,而且它的时间消耗实在是大,我还是不太敢相信它的结果。
对于SVM和逻辑回归,考虑到运行时间,我最终选择了逻辑回归,虽然对于非线性关系建模能力有限,但毕竟简单又高效,谁不喜欢呢?
五、实验结果与感想
这是我初次学习人工智能所做的实验。在这次实验中,我首次接触相关的模型,从它们的理论出发,使用sklearn,keras,tensorflow等库中现成的方法训练了模型。对于训练好的模型,通过相应的验证集来判断其准确率,具体清晰地看到了它们效果的对比,并最终完成了测试集的十分类任务。在这个实验中我也碰到了许许多多的小问题,上网查阅相关的资料、文档助力了问题的解决。
但是我因为初出茅庐,对很多东西都不熟悉,TextCNN实现的效果并不是很好,更没有采用成熟一些的Transformer,XLnet等模型,最终的效果上不是那么好。
愿此开篇之作,能奠基我学习《当代人工智能》这门课,也能为日后研究人工智能打下基础。